概述
对象导入规则支持在数据正式导入前执行自定义 APL 代码,实现数据预处理(如计算汇总字段)和前验证(如业务规则校验)。管理员可分别为“新建导入”和“更新导入”两种时机配置独立的 APL 逻辑,并通过租户级管控统一控制导入时是否触发工作流与审批流。
功能描述
导入数据时,如果希望在导入数据之前进行一些预先的处理工作,可在导入前运行 APL 代码实现。如:
- 场景一:导入订单时,需要计算所有订单行内物料金额之和然后赋值到订单头的"总金额"字段内。
- 场景二:导入预处理时希望数据不会一条出错就全部回滚,让数据分批执行(如一批 20 条)。
功能说明
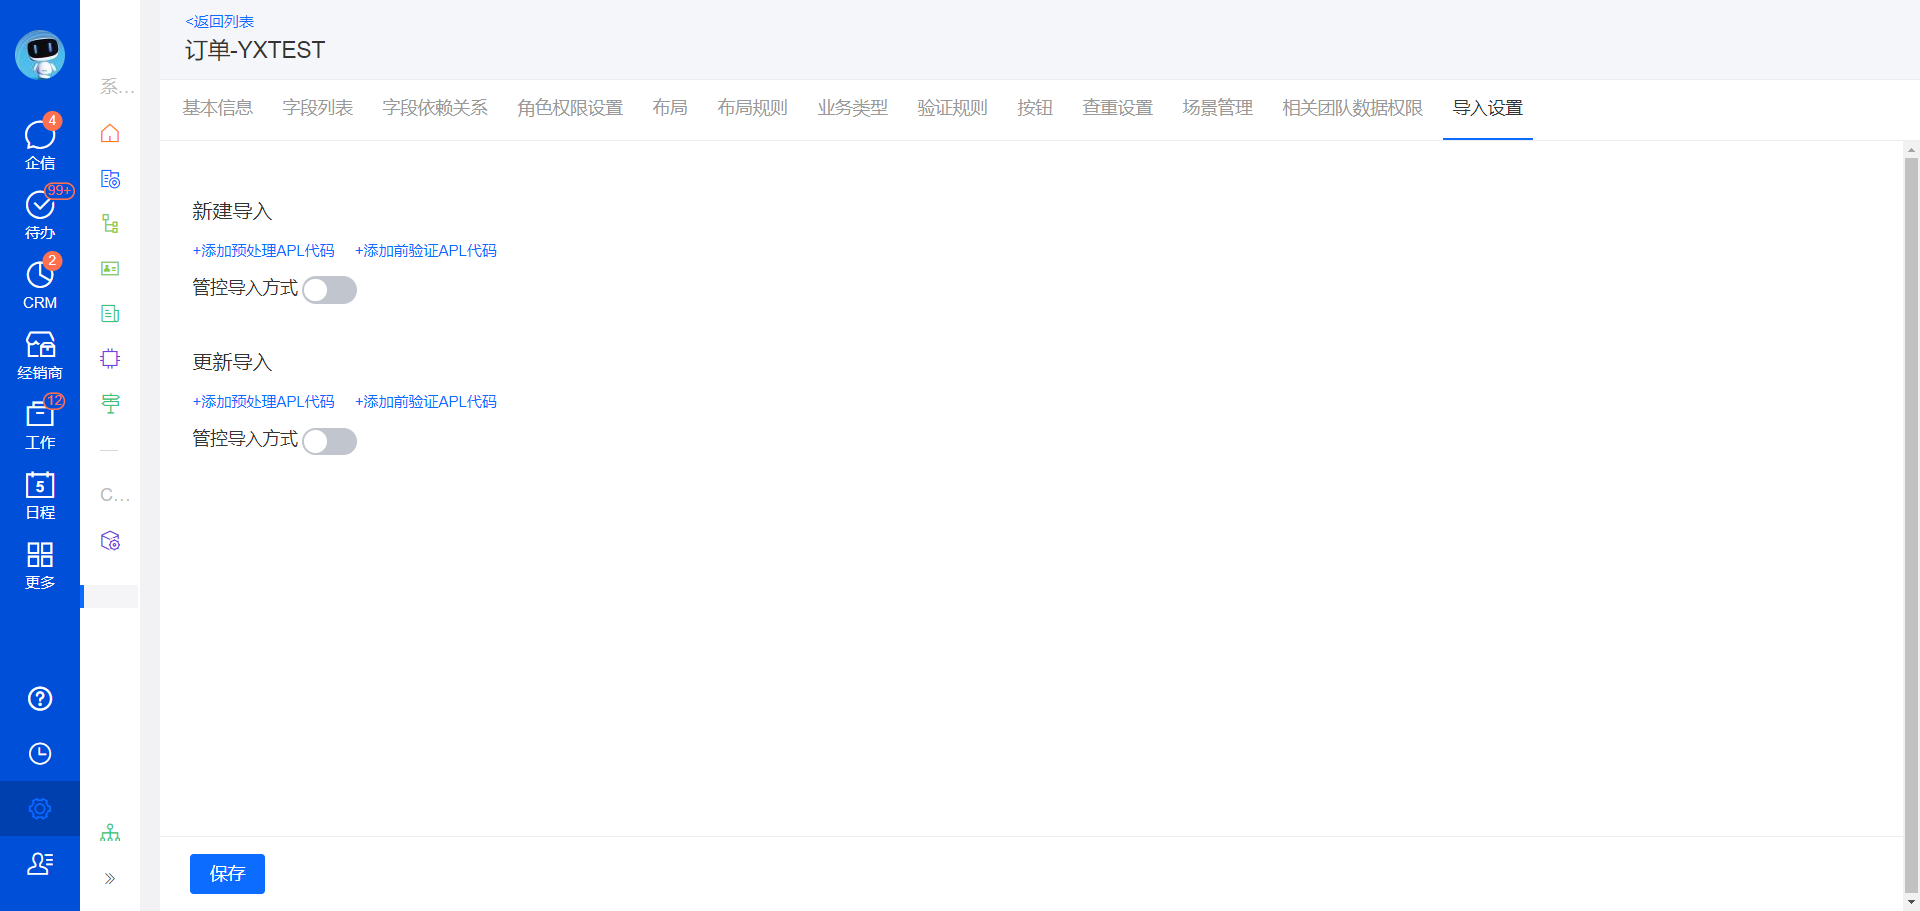
操作路径:【管理后台】→【对象管理】→【自定义对象管理】→【导入设置】
导入数据预处理
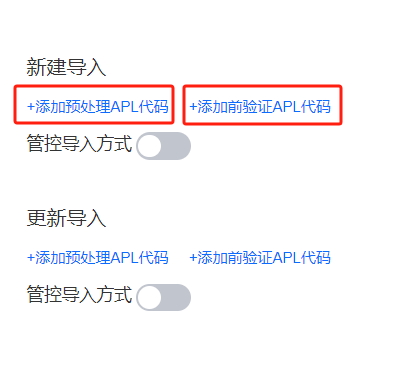
导入的预先处理方式有两种:前验证和预处理。
前验证
- 导入前验证函数和新建编辑的前验证函数类似,可以提示验证信息,同时支持阻断。
- 若数据导入失败,或校验出现错误,错误信息会回填到 Excel 失败列表中。
- 返回值类型为
validateResult。
前验证 APL 代码示例:
// 对导入数据进行赋值
context.data.owner = ["1000"]
// 校验逻辑
ValidateResult validate = ValidateResult.builder()
  .success(false)           // 校验是否成功
  .errorMessage("错误信息") // 校验失败时的错误提示
  .build()
return validate
预处理
- 导入预处理 APL 代码在导入前验证 APL 代码前先执行。
- 一些复杂的导入校验逻辑可以在导入预处理 APL 代码做好相关计算并写入缓存中。
- 到导入前验证 APL 代码执行的时候再从缓存中读出计算结果进行校验。
预处理 APL 代码示例:
def taskId = context.task.taskId as String
log.info(context.task.taskId)    // 获取导入的任务 id
log.info(context.task.lastBatch) // 是否为最后一批数据

// 导入预处理时数据是分批执行的,一批 20 条,放在 context.dataList 中
List<Map> dataList = context.dataList as List
// 在 cache 中缓存信息,供前验证函数使用
Cache cache = Fx.cache.defaultCache
dataList.each{ data ->
  def rowNo = data._RowNo as String
  def name = data.field_MG1ch__c as String
  def key = taskId + "_" + rowNo
  log.info(key)
  def value = "" + name
  cache.put(key, value, 30)
}

return ValidateResult.builder()
  .success(false)  // 返回 false 将终止本次导入
  .errorMessage("test")
  .build()
处理时机
导入的处理时机有两种:新建导入时或更新导入时。两种处理时机均支持添加预处理和前验证 APL。
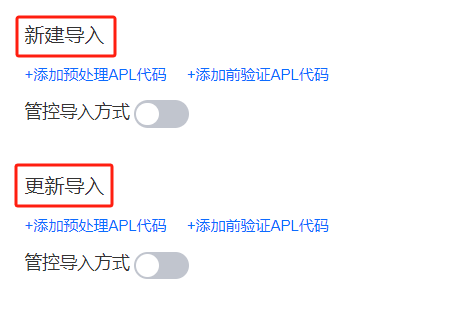
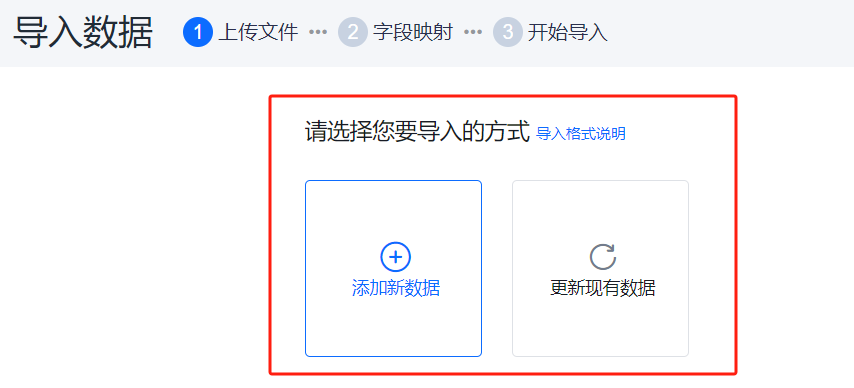
以上两种导入时机分别对应前台导入时的两种方式:添加新数据和更新现有数据。
在前台使用这两种导入方式时会运行对应配置的 APL 代码。
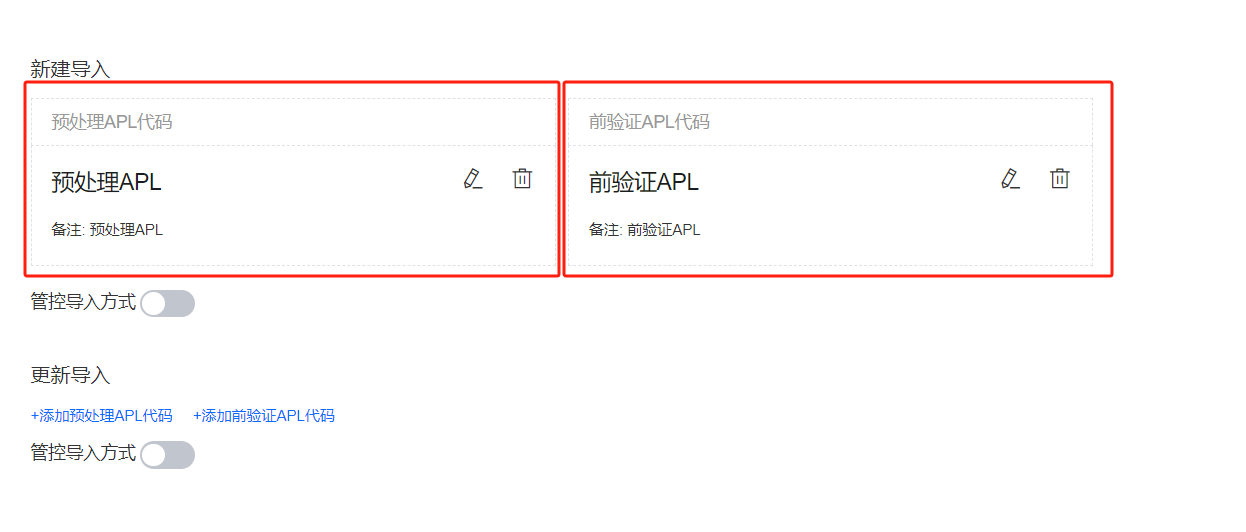
每种处理时机下的预处理 APL 和前验证 APL 都仅可添加一个,处理逻辑请在一个 APL 代码中写全。
管控导入方式
两种处理时机均可"管控导入方式",两者可管控范围不同:
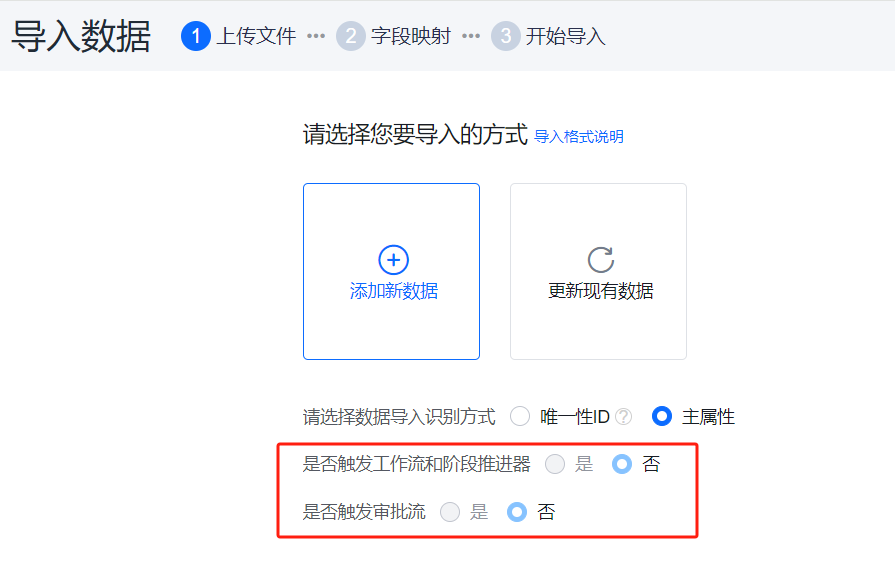
- 新建导入:【是否触发工作流和阶段推进器】和【是否触发审批流】
- 更新导入:【是否触发工作流】
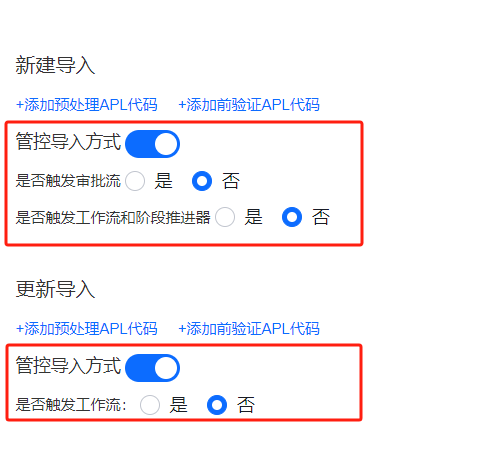
在管理后台处为租户级管控,此处设置后前台导入时该选项将同步此处配置且禁用。